1.3 Exemple : dosage des nitrates dans l’eau de mer
Les nitrates NO3- sont des nutriments essentiels pour la croissance des plantes et des algues. Cependant, un excès de nitrates dans l’eau peut entraîner une prolifération excessive d’algues, ce qui peut avoir des effets néfastes sur les écosystèmes aquatiques. Parfois, le nitrates sont présents en trop faibles quantités dans des eaux très oligothrophes, et les algues peinent à s’y développer. Il est donc important de surveiller les niveaux de nitrates dans l’eau de mer, tant en océanographie biologique qu’en aquariophilie.
L’autoanalyzer AA3 de Seal permet d’automatiser les mesures de nitrates dans l’eau de mer. Le principe du dosage consiste à d’abord réduire les nitrates en nitrites NO2- en passant l’échantillon sur des billes de cadmium-cuivre, puis à faire réagir ces derniers avec du N-(1-naphthyl)-éthylènediamine en présence de sulfanilamide. Cette réaction produit un colorant azoïque dont l’absorbance est mesurée à la longueur d’onde de 520 nm. À noter que cette technique mesure, en fait, la somme nitrates + nitrites, si des nitrites sont déjà présents dans les échantillons. Pour déterminer les nitrates seuls, il faut réaliser la même réaction sans l’étape de réduction sur colonne de cadmium et retirer la concentration en nitrites ainsi mesurée. Pour cette raison, nous parlerons désormais de NOx comme étant la somme des concentrations en nitrates et en nitrites dans nos échantillons.
1.3.1 Encodage ou importation des données
Comme toujours, la première étape de notre analyse consiste à introduire les données brutes dans R dans un format correct. Si nos données ne sont pas encore encodées dans un fichier, nous pouvons utiliser toutes les techniques vues au cours 1, notamment lors de l’exercice d’encodage des données biométriques. Les options sont :
- Encodage direct dans R avec les fonctions
data.frame()(R de base),dplyr::tribble()outibble::tibble()(tidyverse), ou encore avecdtx()oudtx_rows()(SciViews::R). - Encodage dans un fichier Excel, Google Sheet, Libreoffice Calc… et importation, par exemple avec
read()de SciViews::R oureadxl::read_excel()(tidyverse) - Encodage dand un fichier texte, en utilisant la virgule comme séparateur de champs et l’extension
.csv, et importation avecread()de SciViews::R oureadr::read_csv()(tidyverse). Si vous encodez manuellement un fichier CSV, nous vous conseillons d’utiliser un éditeur spécialisé comme ModernCSV qui vous rendra la tâche plus facile et vous évitera de faire des erreurs de formattage des données.
Une autre situation qui peut se présenter à vous est un appareil qui enregistre les résultats directement dans un fichier texte. Dans ce cas, il est souvent nécessaire de nettoyer le fichier avant de pouvoir l’importer dans R. Il n’est pas rare d’avoir, en effet, des informations supplémentaires fournies par l’appareil dans l’entête du fichier (ses premières lignes). Voyez la documentation de votre appareil de mesures. L’autoanalyzer AA3 étant dans ce cas de figure, nous allons maintenant voir comment traiter ce type de données avec R. Ci-dessous, les premières lignes d’un fichier issus directement de l’AA3 :
#  [1] "\"ANAL\";\"NPinorganique.ANL\";;;;;;;;;;;;;;;;;"
#  [2] "\"RUN \";\"171124B.RUN\";;;;;;;;;;;;;;;;;"
#  [3] "\"DATE\";\"24/11/2017\";;;;;;;;;;;;;;;;;"
#  [4] "\"TIME\";\"14:41:59\";;;;;;;;;;;;;;;;;"
#  [5] "\"OPER\";\"testcal\";;;;;;;;;;;;;;;;;"
#  [6] "\"COMM\";\"Testcal\";;;;;;;;;;;;;;;;;"
#  [7] "\"TYPE\";;;;;;;;;\"Real\";;;\"Real\";;;\"Real\";;;"
#  [8] "\"CHAN\";;;;;;;;;1;;;2;;;3;;;"
#  [9] "\"METH\";;;;;;;;;\"PO4\";;;\"NO3\";;;\"NH4\";;;"
# [10] "\"UNIT\";;;;;;;;;\"\xb5mol/L\";;;\"\xb5mol/L\";;;\"\xb5mol/L\";;;"
# [11] "\"Base\";;;;;;;;;-6620;;;-6339;;;-7963;;;"
# [12] "\"Gain\";;;;;;;;;140;;;52;;;143;;;"
# [13] "\"Lamp\";;;;;;;;;257;;;300;;;292;;;"
# [14] "\"Sample ID\";\"Peak Number\";\"Cup Number\";\"Cup Type\";\"Cup Group\";;;\"Date Time Stamp\";;\"Results 1\";\"AD Values\";;\"Results 2\";\"AD Values\";;\"Results 3\";\"AD Values\";;"
# [15] "\"Primer\";1;1;\"PRIM\";0;0;0;\"24/11/2017 14:44:33\";;9.899;60097;;9.966;58043;;9.190;56006;;"
# [16] "\"cal10\";2;2;\"CALB\";0;0;0;\"24/11/2017 14:45:33\";10.000;9.964;60461;10.000;9.948;57946;10.000;9.216;56156;;"
# [17] "\"cal5\";3;3;\"CALB\";0;0;0;\"24/11/2017 14:46:33\";5.000;5.051;32786;5.000;5.089;31734;5.000;5.907;36959;;"
# [18] "\"cal2\";4;4;\"CALB\";0;0;0;\"24/11/2017 14:47:33\";2.000;2.020;15708;2.000;2.030;15236;2.000;2.445;16870;;"
# [19] "\"cal1\";5;5;\"CALB\";0;0;0;\"24/11/2017 14:48:33\";1.000;1.023;10090;1.000;0.994;9648;1.000;1.188;9581;;"
# [20] "\"cal0.5\";6;6;\"CALB\";0;0;0;\"24/11/2017 14:49:33\";0.500;0.600;7711;0.500;0.521;7094;0.500;0.778;7200;;"
Nous pouvons voir immédiatement plusieurs choses :
- Le fichier est bien un fichier texte,
- Le séparateur de champs est ici le point virgule
;, - L’entête occupe les 13 premières lignes et renseigne une série de métadonnées relatives à l’analyse et à l’appareil. Par exemple, ligne 9, on peut lire que les 3 méthodes d’analyse sont, dans l’ordre, , PO4 (les phosphates), NO3 (les nitrates + nitrites), et NH4 (ammonium + ammoniac). De même, ligne 10, on voit que les unités des concentrations sont “xb5mol/L”… Huummm ! Drôle d’unité. En fait ici, nous n’avons pas utilisé le bon encodage. Si nous relisons cette ligne 10 avec un encodage “latin1”, typique d’un Windows en français, nous avons alors ceci :
# [1] "\"UNIT\";;;;;;;;;\"µmol/L\";;;\"µmol/L\";;;\"µmol/L\";;;"Donc, les unités sont des µmol/L.
L’entête des colonnes est en ligne 14 et les données commencent en ligne 15. Comme nous avons un peu de remaniement des données à réaliser également, nous pouvons écrire une petite fonction en R pour automatiser le tout :
read_aa3 <- function(aa3_file) {
  # Lecture du fichier brut (encodage latin1, séparateur ';', décimale '.')
  data <- read.csv2(aa3_file, skip = 13, header = TRUE, dec = ".",
    fileEncoding = "latin1", stringsAsFactors = FALSE, na.strings = "")
  # Sélection et renommage des colonnes d'intérêt
  data <- data[, c("Sample.ID", "Peak.Number", "Cup.Number", "Cup.Type",
    "Cup.Group", "Date.Time.Stamp", "X.2", "AD.Values",
    "X.3", "AD.Values.1", "X.4", "AD.Values.2")]
  names(data) <- c("sample_id", "peak_number", "cup_number", "cup_type",
    "cup_group", "date_time", "PO4__umol_L", "abs.PO4",
    "NOx__umol_L", "abs.NOx", "NH4__umol_L", "abs.NH4")
  # Conversion de variables
  data$cup_type <- as.factor(data$cup_type)
  data$cup_group <- as.factor(data$cup_group)
  data$date_time <- as.POSIXct(data$date_time, format = "%d/%m/%Y %H:%M:%OS")

  data
}
Vous êtes maintenant habitué à ce type de reman,iement de données. Ici, nous n’avons utilisé que du R de base pour le réaliser, mais vous pouvez également utiliser la syntaxe SciViews::R à laquelle vous êtes peut-être plus habitué•e. Nous pouvons maintenant importer nos données proprement et les placer sur un graphique :
#    sample_id peak_number cup_number cup_type cup_group           date_time
# 1     Primer           1          1     PRIM         0 2017-11-24 14:44:33
# 2      cal10           2          2     CALB         0 2017-11-24 14:45:33
# 3       cal5           3          3     CALB         0 2017-11-24 14:46:33
# 4       cal2           4          4     CALB         0 2017-11-24 14:47:33
# 5       cal1           5          5     CALB         0 2017-11-24 14:48:33
# 6     cal0.5           6          6     CALB         0 2017-11-24 14:49:33
# 7     cal0.3           7          7     CALB         0 2017-11-24 14:50:33
# 8     cal0.2           8          8     CALB         0 2017-11-24 14:51:33
# 9     cal0.1           9          9     CALB         0 2017-11-24 14:52:33
# 10      cal0          10         10     CALB         0 2017-11-24 14:53:33
# 11     Drift          11         11     DRIF         0 2017-11-24 14:54:33
# 12     cal10          12         12     SAMP         0 2017-11-24 14:55:33
# 13      cal5          13         13     SAMP         0 2017-11-24 14:56:33
# 14      cal2          14         14     SAMP         0 2017-11-24 14:57:33
# 15      cal1          15         15     SAMP         0 2017-11-24 14:58:33
# 16    cal0.5          16         16     SAMP         0 2017-11-24 14:59:33
# 17    cal0.3          17         17     SAMP         0 2017-11-24 15:00:33
# 18    cal0.2          18         18     SAMP         0 2017-11-24 15:01:33
# 19    cal0.1          19         19     SAMP         0 2017-11-24 15:02:33
# 20      cal0          20         20     SAMP         0 2017-11-24 15:03:33
# 21     Drift          21         21     DRIF         0 2017-11-24 15:04:33
# 22      cal0          22         22     SAMP         0 2017-11-24 15:05:33
# 23    cal0.1          23         23     SAMP         0 2017-11-24 15:06:33
# 24    cal0.2          24         24     SAMP         0 2017-11-24 15:07:33
# 25    cal0.3          25         25     SAMP         0 2017-11-24 15:08:33
# 26    cal0.5          26         26     SAMP         0 2017-11-24 15:09:33
# 27      cal1          27         27     SAMP         0 2017-11-24 15:10:33
# 28      cal2          28         28     SAMP         0 2017-11-24 15:11:33
# 29      cal5          29         29     SAMP         0 2017-11-24 15:12:33
# 30     cal10          30         30     SAMP         0 2017-11-24 15:13:33
# 31     Drift          31         31     DRIF         0 2017-11-24 15:14:33
# 32     cal10          32         32     SAMP         0 2017-11-24 15:15:33
# 33      cal0          33         33     SAMP         0 2017-11-24 15:16:33
# 34      cal5          34         34     SAMP         0 2017-11-24 15:17:33
# 35    cal0.1          35         35     SAMP         0 2017-11-24 15:18:33
# 36      cal2          36         36     SAMP         0 2017-11-24 15:19:33
# 37    cal0.2          37         37     SAMP         0 2017-11-24 15:20:33
# 38      cal1          38         38     SAMP         0 2017-11-24 15:21:33
# 39    cal0.3          39         39     SAMP         0 2017-11-24 15:22:33
# 40    cal0.5          40         40     SAMP         0 2017-11-24 15:23:33
# 41     Drift          41         41     DRIF         0 2017-11-24 15:24:33
# 42     cal10          42         42     SAMP         0 2017-11-24 15:25:33
# 43      cal0          43         43     SAMP         0 2017-11-24 15:26:33
# 44      cal5          44         44     SAMP         0 2017-11-24 15:27:33
# 45    cal0.1          45         45     SAMP         0 2017-11-24 15:28:33
# 46      cal2          46         46     SAMP         0 2017-11-24 15:29:33
# 47    cal0.2          47         47     SAMP         0 2017-11-24 15:30:33
# 48      cal1          48         48     SAMP         0 2017-11-24 15:31:33
# 49    cal0.3          49         49     SAMP         0 2017-11-24 15:32:33
# 50    cal0.5          50         50     SAMP         0 2017-11-24 15:33:33
# 51     Drift          51         51     DRIF         0 2017-11-24 15:34:33
# 52       End          52          0     END          0 2017-11-24 15:35:33
#    PO4__umol_L abs.PO4 NOx__umol_L abs.NOx NH4__umol_L abs.NH4
# 1           NA   60097          NA   58043          NA   56006
# 2         10.0   60461        10.0   57946        10.0   56156
# 3          5.0   32786         5.0   31734         5.0   36959
# 4          2.0   15708         2.0   15236         2.0   16870
# 5          1.0   10090         1.0    9648         1.0    9581
# 6          0.5    7711         0.5    7094         0.5    7200
# 7          0.3    5770         0.3    5940         0.3    4899
# 8          0.2    5212         0.2    5134         0.2    1846
# 9          0.1    4715         0.1    4901         0.1    1212
# 10         0.0    4112         0.0    3952         0.0     267
# 11          NA   59945          NA   58246          NA   56088
# 12          NA   60105          NA   58336          NA   56446
# 13          NA   32420          NA   31907          NA   37299
# 14          NA   15757          NA   16443          NA   14898
# 15          NA   10203          NA    9793          NA    7970
# 16          NA    7472          NA    8025          NA    6682
# 17          NA    6531          NA    5836          NA    1945
# 18          NA    5464          NA    5140          NA     996
# 19          NA    5089          NA    4562          NA     909
# 20          NA    4585          NA    4015          NA     314
# 21          NA   59945          NA   58246          NA   56088
# 22          NA    4852          NA    4232          NA     412
# 23          NA    6280          NA    4580          NA    1163
# 24          NA    6954          NA    5774          NA    4022
# 25          NA    6517          NA    5686          NA    2383
# 26          NA    7280          NA    6768          NA    5065
# 27          NA   10356          NA    9584          NA    7702
# 28          NA   16111          NA   15673          NA   13736
# 29          NA   32925          NA   31748          NA   36854
# 30          NA   59713          NA   58085          NA   56064
# 31          NA   59945          NA   58246          NA   56088
# 32          NA   59801          NA   58479          NA   56198
# 33          NA    4166          NA    4180          NA     133
# 34          NA   32051          NA   31927          NA   36522
# 35          NA    4850          NA    5078          NA     875
# 36          NA   15482          NA   16030          NA   13502
# 37          NA    5407          NA    5158          NA    1264
# 38          NA   10069          NA   10076          NA    8497
# 39          NA    6194          NA    6436          NA    1854
# 40          NA    7244          NA    6825          NA    4860
# 41          NA   59945          NA   58246          NA   56088
# 42          NA   59892          NA   58120          NA   55986
# 43          NA    4360          NA    4081          NA       0
# 44          NA   32389          NA   33524          NA   37252
# 45          NA    5044          NA    4709          NA       0
# 46          NA   15817          NA   15209          NA   11625
# 47          NA    5602          NA    5147          NA     346
# 48          NA   10102          NA    9732          NA    7090
# 49          NA    6352          NA    5733          NA    3023
# 50          NA    7787          NA    7411          NA    3970
# 51          NA   59945          NA   58246          NA   56088
# 52          NA    4311          NA    3646          NA       5
Nous voyons qu’il s’agit ici de solution standard de calibration nommée “calxx” où “xx” est la concentration connue en µmol/L… mais la concentration n’a été correctement encodée que pour la première série indiquée cub_type == "CALB". Nous allons y remédier en indiquant les concentrations correctes pour les autres lignes du tableau :
# Récupération des concentrations à partir de l'identifiant des échantillons
conc <- substring(calib$sample_id, 4) |> as.numeric()
# Warning: NAs introduced by coercion# [1] NA 10.0 5.0 2.0 1.0 0.5 0.3 0.2 0.1 0.0 NA 10.0 5.0 2.0 1.0
# [16] 0.5 0.3 0.2 0.1 0.0 NA 0.0 0.1 0.2 0.3 0.5 1.0 2.0 5.0 10.0
# [31] NA 10.0 0.0 5.0 0.1 2.0 0.2 1.0 0.3 0.5 NA 10.0 0.0 5.0 0.1
# [46] 2.0 0.2 1.0 0.3 0.5 NA NA… et nous remplaçons les concentrations par ces valeurs dans le tableau. Ensuite, nous éliminons les lignes qui ne correspondent pas à une solution de calibration, dont la concentration est NA :
calib$PO4__umol_L <- conc
calib$NOx__umol_L <- conc
calib$NH4__umol_L <- conc
calib <- drop_na_(calib, "PO4__umol_L")
calib
# sample_id peak_number cup_number cup_type cup_group date_time
# 1 cal10 2 2 CALB 0 2017-11-24 14:45:33
# 2 cal5 3 3 CALB 0 2017-11-24 14:46:33
# 3 cal2 4 4 CALB 0 2017-11-24 14:47:33
# 4 cal1 5 5 CALB 0 2017-11-24 14:48:33
# 5 cal0.5 6 6 CALB 0 2017-11-24 14:49:33
# 6 cal0.3 7 7 CALB 0 2017-11-24 14:50:33
# 7 cal0.2 8 8 CALB 0 2017-11-24 14:51:33
# 8 cal0.1 9 9 CALB 0 2017-11-24 14:52:33
# 9 cal0 10 10 CALB 0 2017-11-24 14:53:33
# 10 cal10 12 12 SAMP 0 2017-11-24 14:55:33
# 11 cal5 13 13 SAMP 0 2017-11-24 14:56:33
# 12 cal2 14 14 SAMP 0 2017-11-24 14:57:33
# 13 cal1 15 15 SAMP 0 2017-11-24 14:58:33
# 14 cal0.5 16 16 SAMP 0 2017-11-24 14:59:33
# 15 cal0.3 17 17 SAMP 0 2017-11-24 15:00:33
# 16 cal0.2 18 18 SAMP 0 2017-11-24 15:01:33
# 17 cal0.1 19 19 SAMP 0 2017-11-24 15:02:33
# 18 cal0 20 20 SAMP 0 2017-11-24 15:03:33
# 19 cal0 22 22 SAMP 0 2017-11-24 15:05:33
# 20 cal0.1 23 23 SAMP 0 2017-11-24 15:06:33
# 21 cal0.2 24 24 SAMP 0 2017-11-24 15:07:33
# 22 cal0.3 25 25 SAMP 0 2017-11-24 15:08:33
# 23 cal0.5 26 26 SAMP 0 2017-11-24 15:09:33
# 24 cal1 27 27 SAMP 0 2017-11-24 15:10:33
# 25 cal2 28 28 SAMP 0 2017-11-24 15:11:33
# 26 cal5 29 29 SAMP 0 2017-11-24 15:12:33
# 27 cal10 30 30 SAMP 0 2017-11-24 15:13:33
# 28 cal10 32 32 SAMP 0 2017-11-24 15:15:33
# 29 cal0 33 33 SAMP 0 2017-11-24 15:16:33
# 30 cal5 34 34 SAMP 0 2017-11-24 15:17:33
# 31 cal0.1 35 35 SAMP 0 2017-11-24 15:18:33
# 32 cal2 36 36 SAMP 0 2017-11-24 15:19:33
# 33 cal0.2 37 37 SAMP 0 2017-11-24 15:20:33
# 34 cal1 38 38 SAMP 0 2017-11-24 15:21:33
# 35 cal0.3 39 39 SAMP 0 2017-11-24 15:22:33
# 36 cal0.5 40 40 SAMP 0 2017-11-24 15:23:33
# 37 cal10 42 42 SAMP 0 2017-11-24 15:25:33
# 38 cal0 43 43 SAMP 0 2017-11-24 15:26:33
# 39 cal5 44 44 SAMP 0 2017-11-24 15:27:33
# 40 cal0.1 45 45 SAMP 0 2017-11-24 15:28:33
# 41 cal2 46 46 SAMP 0 2017-11-24 15:29:33
# 42 cal0.2 47 47 SAMP 0 2017-11-24 15:30:33
# 43 cal1 48 48 SAMP 0 2017-11-24 15:31:33
# 44 cal0.3 49 49 SAMP 0 2017-11-24 15:32:33
# 45 cal0.5 50 50 SAMP 0 2017-11-24 15:33:33
# PO4__umol_L abs.PO4 NOx__umol_L abs.NOx NH4__umol_L abs.NH4
# 1 10.0 60461 10.0 57946 10.0 56156
# 2 5.0 32786 5.0 31734 5.0 36959
# 3 2.0 15708 2.0 15236 2.0 16870
# 4 1.0 10090 1.0 9648 1.0 9581
# 5 0.5 7711 0.5 7094 0.5 7200
# 6 0.3 5770 0.3 5940 0.3 4899
# 7 0.2 5212 0.2 5134 0.2 1846
# 8 0.1 4715 0.1 4901 0.1 1212
# 9 0.0 4112 0.0 3952 0.0 267
# 10 10.0 60105 10.0 58336 10.0 56446
# 11 5.0 32420 5.0 31907 5.0 37299
# 12 2.0 15757 2.0 16443 2.0 14898
# 13 1.0 10203 1.0 9793 1.0 7970
# 14 0.5 7472 0.5 8025 0.5 6682
# 15 0.3 6531 0.3 5836 0.3 1945
# 16 0.2 5464 0.2 5140 0.2 996
# 17 0.1 5089 0.1 4562 0.1 909
# 18 0.0 4585 0.0 4015 0.0 314
# 19 0.0 4852 0.0 4232 0.0 412
# 20 0.1 6280 0.1 4580 0.1 1163
# 21 0.2 6954 0.2 5774 0.2 4022
# 22 0.3 6517 0.3 5686 0.3 2383
# 23 0.5 7280 0.5 6768 0.5 5065
# 24 1.0 10356 1.0 9584 1.0 7702
# 25 2.0 16111 2.0 15673 2.0 13736
# 26 5.0 32925 5.0 31748 5.0 36854
# 27 10.0 59713 10.0 58085 10.0 56064
# 28 10.0 59801 10.0 58479 10.0 56198
# 29 0.0 4166 0.0 4180 0.0 133
# 30 5.0 32051 5.0 31927 5.0 36522
# 31 0.1 4850 0.1 5078 0.1 875
# 32 2.0 15482 2.0 16030 2.0 13502
# 33 0.2 5407 0.2 5158 0.2 1264
# 34 1.0 10069 1.0 10076 1.0 8497
# 35 0.3 6194 0.3 6436 0.3 1854
# 36 0.5 7244 0.5 6825 0.5 4860
# 37 10.0 59892 10.0 58120 10.0 55986
# 38 0.0 4360 0.0 4081 0.0 0
# 39 5.0 32389 5.0 33524 5.0 37252
# 40 0.1 5044 0.1 4709 0.1 0
# 41 2.0 15817 2.0 15209 2.0 11625
# 42 0.2 5602 0.2 5147 0.2 346
# 43 1.0 10102 1.0 9732 1.0 7090
# 44 0.3 6352 0.3 5733 0.3 3023
# 45 0.5 7787 0.5 7411 0.5 3970Parfait ! Maintenant, le graphique…
chart(data = calib, abs.NOx ~ NOx__umol_L) +
  geom_point() +
  labs(x = "Concentration en NOx [µmol/L]", y = "Absorbance")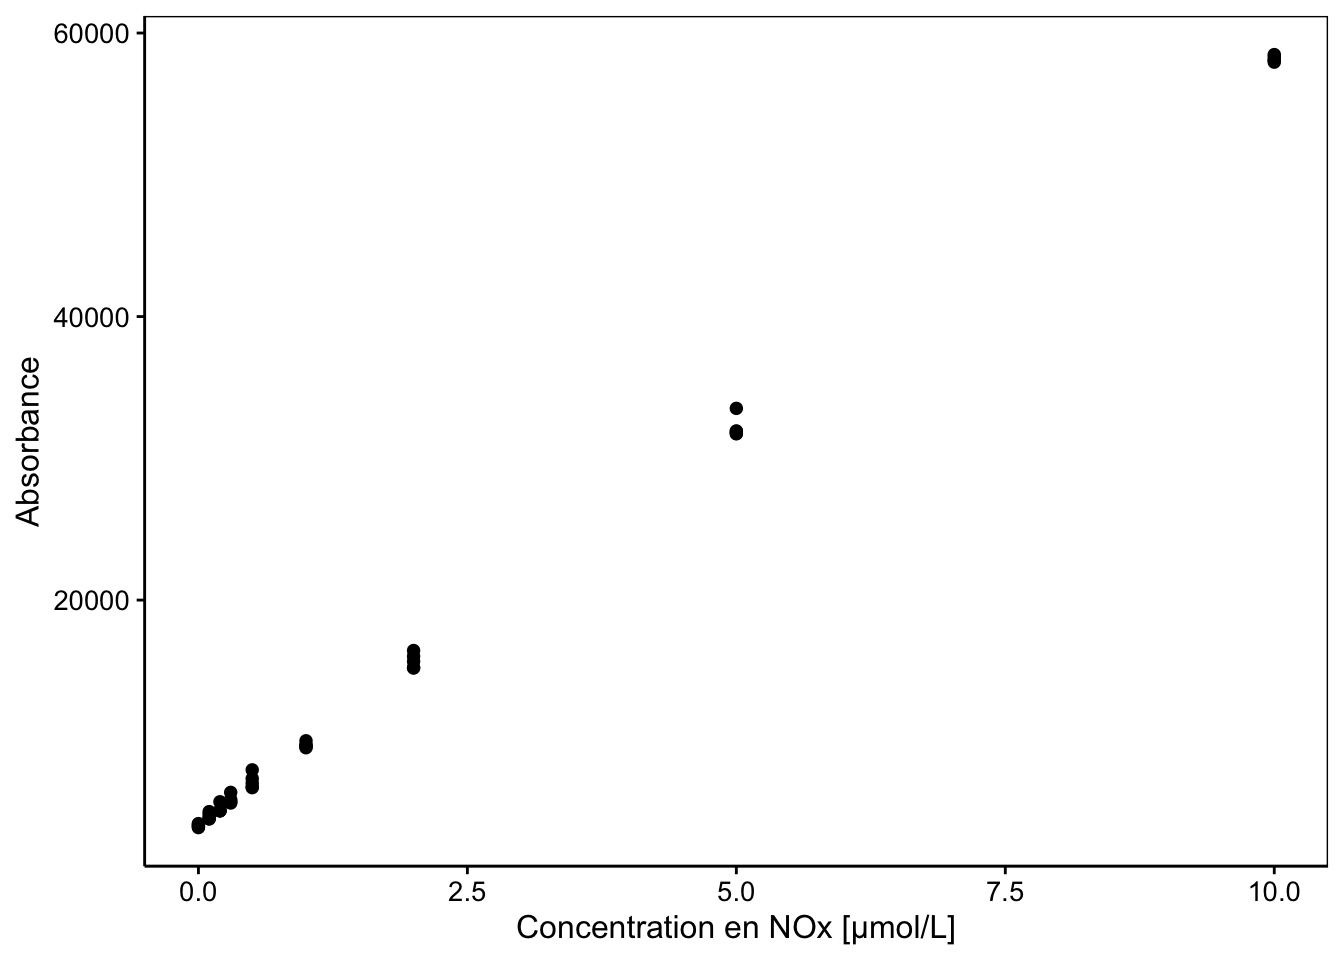
Notez que nous plaçons la concentration en abscisse et l’absorbance en ordonnée. C’est la convention pour les droites de calibration. Nous verrons dans les deux chapitres suivants que la méthode statistique d’ajustement de la droite de calibration considère qu’il n’y a pas d’erreur sur l’axe X et que toute l’erreur est reportée su Y. Or nous avons moins d’erreur sur la concentration de nos solutions standard que sur l’absorbance. Donc, nous plaçons la concentration en X pour se rapprocher de cette contrainte.
1.3.2 Calcul de la droite de calibration avec R
Nous voyons que les points s’alignent bien le long d’une droite dans notre jeu de données exemple, ce qui est une bonne nouvelle. Nous pouvons rajouter la droite qui se place au mieux dans le nuage de points comme ceci sur notre graphique :
SciViews::R
chart(data = calib, abs.NOx ~ NOx__umol_L) +
  geom_point() +
  # Droite de calibration
  geom_smooth(method = "lm", color = "blue") +
  labs(x = "Concentration en NOx [µmol/L]", y = "Absorbance")
# `geom_smooth()` using formula = 'y ~ x'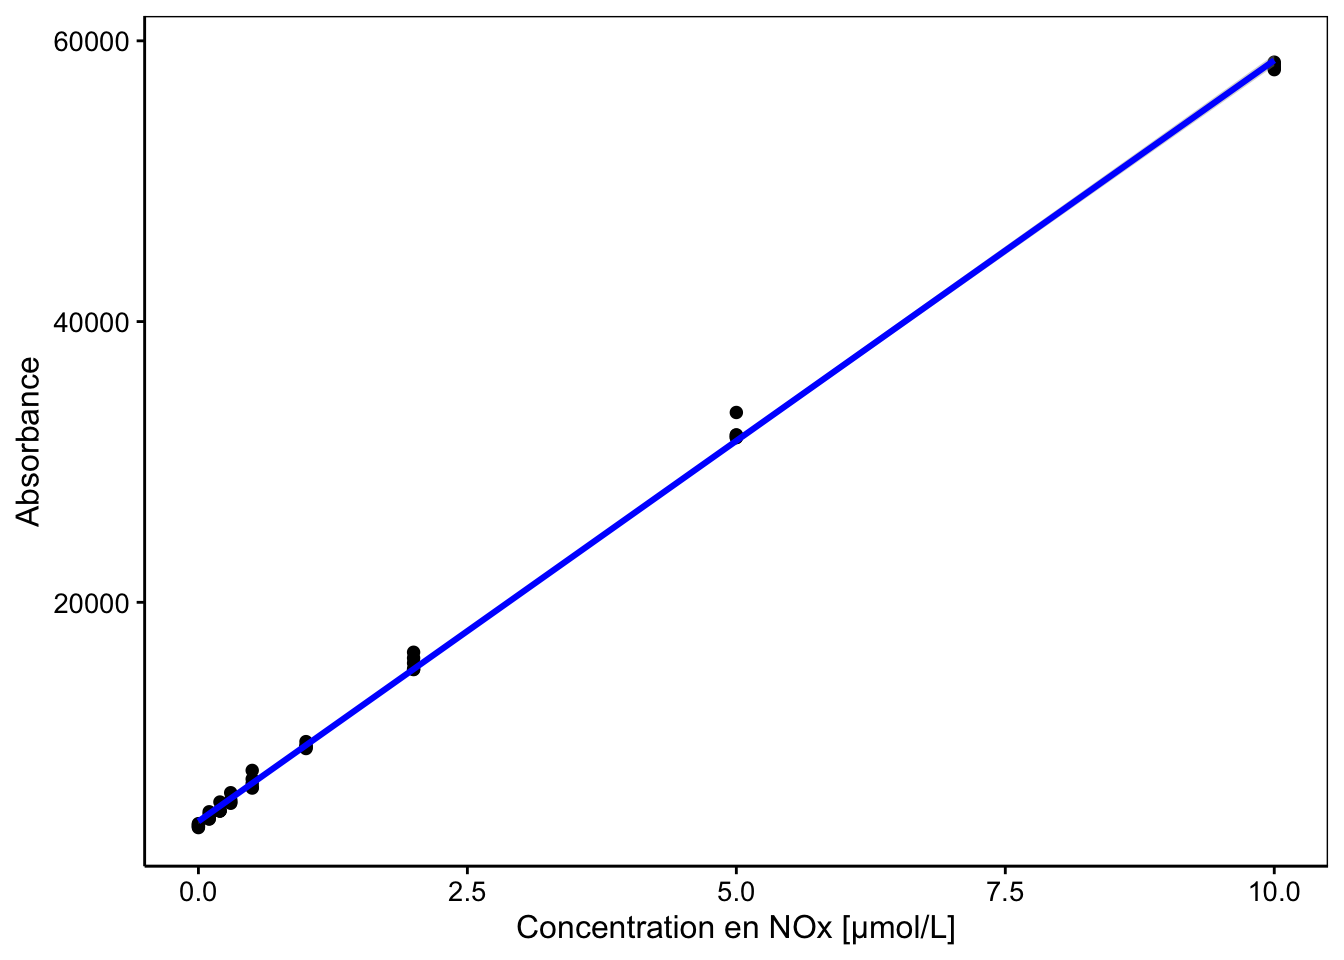
Dans R, cette droite se calcule avec la fonction lm() comme ceci :
#
# Call:
# lm(formula = abs.NOx ~ NOx__umol_L, data = calib)
#
# Coefficients:
# (Intercept)  NOx__umol_L
#        4397         5422
Dans le petit tableau “Coefficients”, “(Intercept)” est l’ordonnée à l’origine et “NOx__umol_L” est la pente de la droite par rapport à cette variable. Notre droite de calibration a donc la forme mathématique suivante :
\[Absorbance = 5422 \times NOx + 4397\]
Dans les deux chapitres suivants, nous étudierons la théorie relative à la droitegalement quelques descripteurs et tests statistiques autour de cette droite, afin de vérifier que le modèle utilisé est correct, ou de calculer l’incertitiude sur la position de la droite. En cas de problème, ces outils statistiques nous aideront également à les diagnostiquer plus en détails.
1.3.3 Droite de calibration avec {chemCal}
Le package additionnel {chemCal} fournit des fonctions qui vont nous faciliter la vie et aussi nous permettre d’avoir plus d’information sur nos dosages. Par exemple, en partant de note objet calib_lm, nous pouvons réaliser un graphique plus complet à l’aide de la fonction calplot() :
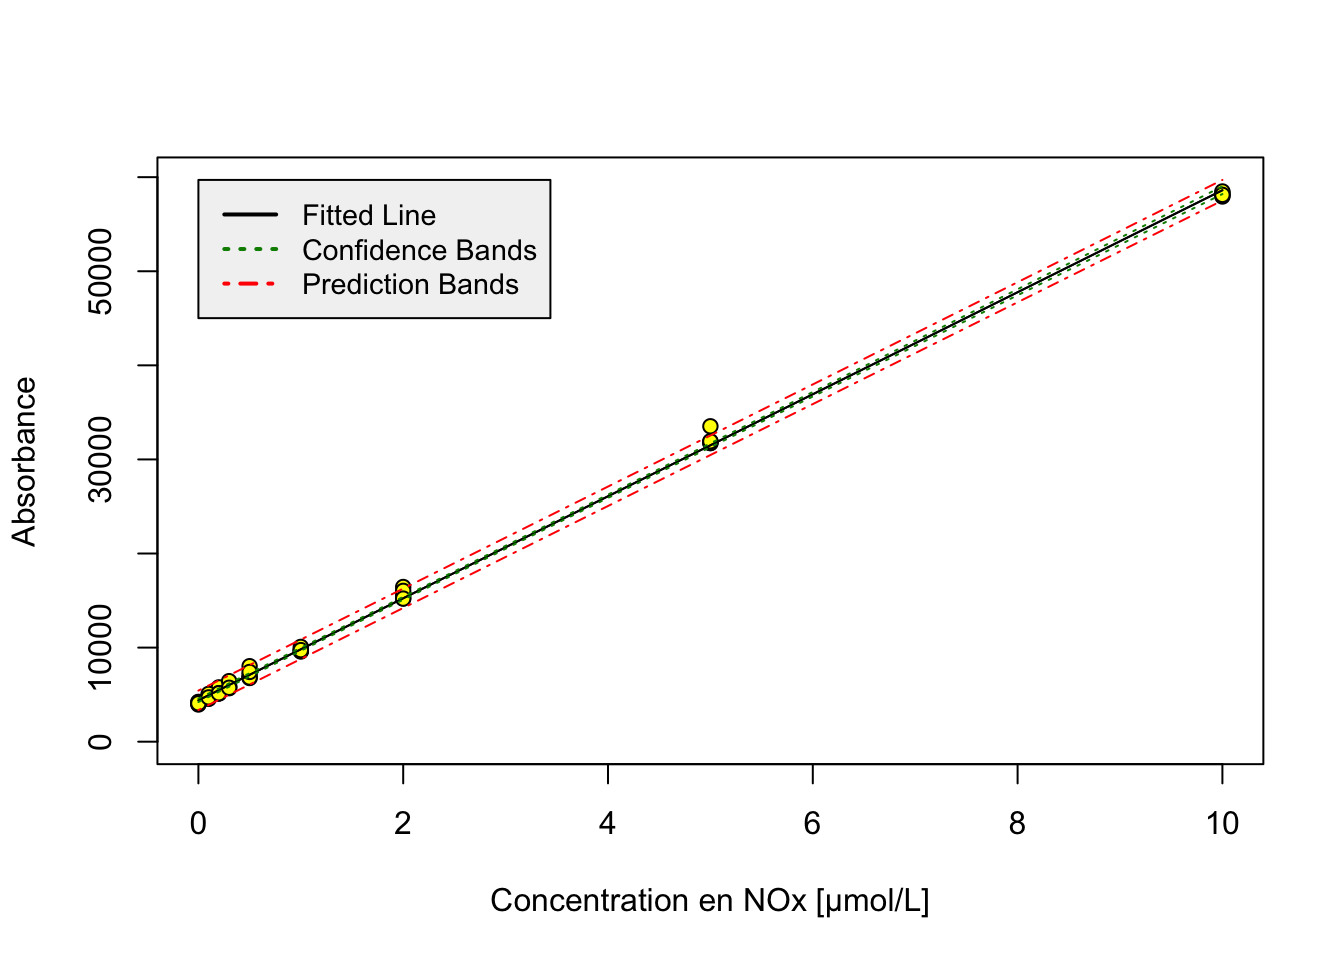
Ici, nous avons une présentation un peu différente du graphique (c’est un graphique R de base), mais surtout, nous avons des traits verts et rouges qui sont ajoutés autour de la droite de calibration en noir. Ces traits matérialisent des informations statistiques complémentaires et importantes. Les traits verts correspondent à l’enveloppe de confiance à 95% qui indiquent l’incertitude statistique sur le calcul de la droite (l’équivalent de l’intervalle de confiance sur une moyenne que nous avons étudié en SDD II). Ici, ces traits sont très, très proches de la droite de calibration, ce qui nous indique qu’elle est calculée très précisément.
Les traits pointillés rouges indiquent l’incertitude sur la prédiction de la concentration d’un échatillon inconnu, toujours avec une probabilité de 95% (un argument alpha=, qui vaut 0.05 par défaut permet éventuellement de changer la probabilité de ces bandes supplémentaires, si on le désire). Ces intervalles de prédiction sont à rapprocher du lod() que nous aborderons un peu plus loin.
1.3.4 Détermination de la concentration d’échantillons inconnus
Avec le jeu de données traité jusqu’ici, nous n’avions que des solutions standard de concentration connue. Naturellement, l’intérêt d’établir une droite de calibration avec de telles solutions standards, est de pouvoir ensuite passer dans le même appareil des solutions de concentration inconnue, et de les calculer. Nous allons refaire le traitement avec un autre jeu de données issu du même autoanalyze AA3, et qui contient des solutions de concentration inconnue. Nous travaillerons directement avec {chemCal} et réutilisons naturellement notre fonction read_aa3() bien pratique ici :
ana <- read_aa3("data/sdd2_01/171124AR1.TXT")
# Nous ne conservons ici que les 20 premières lignes du tableau
ana <- ana[1:20, ]
ana
# sample_id peak_number cup_number cup_type cup_group
# 1 Primer 1 1 PRIM 0
# 2 cal10 2 2 CALB 0
# 3 cal5 3 3 CALB 0
# 4 cal2 4 4 CALB 0
# 5 cal1 5 5 CALB 0
# 6 cal0.5 6 6 CALB 0
# 7 cal0.3 7 7 CALB 0
# 8 cal0.2 8 8 CALB 0
# 9 cal0.1 9 9 CALB 0
# 10 cal0 10 10 CALB 0
# 11 Drift 11 11 DRIF 0
# 12 20171122 09:01 1F 12 12 SAMP 0
# 13 20171122 09:01 2F 13 13 SAMP 0
# 14 20171122 09:01 3F 14 14 SAMP 0
# 15 20171122 09:01 4F 15 15 SAMP 0
# 16 20171122 09:01 5F 16 16 SAMP 0
# 17 20171122 09:01 6F 17 17 SAMP 0
# 18 20171122 09:59 1O 18 18 SAMP 0
# 19 20171122 09:59 2O 19 19 SAMP 0
# 20 20171122 09:59 3O 20 20 SAMP 0
# date_time PO4__umol_L abs.PO4 NOx__umol_L abs.NOx NH4__umol_L
# 1 2017-11-24 12:10:30 NA 59968 NA 60756 NA
# 2 2017-11-24 12:11:30 10.0 59529 10.0 60936 10.0
# 3 2017-11-24 12:12:30 5.0 32560 5.0 32840 5.0
# 4 2017-11-24 12:13:30 2.0 16006 2.0 15809 2.0
# 5 2017-11-24 12:14:30 1.0 10813 1.0 9694 1.0
# 6 2017-11-24 12:15:30 0.5 7083 0.5 6931 0.5
# 7 2017-11-24 12:16:30 0.3 5880 0.3 5726 0.3
# 8 2017-11-24 12:17:30 0.2 5384 0.2 6609 0.2
# 9 2017-11-24 12:18:30 0.1 4714 0.1 4482 0.1
# 10 2017-11-24 12:19:30 0.0 4649 0.0 3850 0.0
# 11 2017-11-24 12:20:30 NA 60113 NA 60729 NA
# 12 2017-11-24 12:21:30 NA 18413 NA 4734 NA
# 13 2017-11-24 12:22:30 NA 19226 NA 6983 NA
# 14 2017-11-24 12:23:30 NA 18957 NA 4526 NA
# 15 2017-11-24 12:24:30 NA 18878 NA 3844 NA
# 16 2017-11-24 12:25:30 NA 19037 NA 3290 NA
# 17 2017-11-24 12:26:30 NA 18244 NA 3601 NA
# 18 2017-11-24 12:27:30 NA 19080 NA 7805 NA
# 19 2017-11-24 12:28:30 NA 19280 NA 8137 NA
# 20 2017-11-24 12:29:30 NA 19309 NA 7726 NA
# abs.NH4
# 1 62202
# 2 62456
# 3 35828
# 4 12978
# 5 6853
# 6 3505
# 7 3713
# 8 2602
# 9 1682
# 10 2826
# 11 61629
# 12 644
# 13 2476
# 14 550
# 15 405
# 16 394
# 17 825
# 18 229
# 19 698
# 20 813Les lignes 2 à 10 se réfèrent à nos solutions standard en les lignes 12 à 20 correspondent à des échantillons de concentration inconnue. Les lignes 1 et 11 correspondent au signal de base obtenu à l’aide d’eau ultrapure, et ne nous intéressent pas. Nous pouvons donc diviser notre tableau en calib2 pour la calibration et samples avec nos échantillons inconnus.
Voici le calcul et la représentation de notre droite de calibration dans ce second cas pour les NOx :
#
# Call:
# lm(formula = abs.NOx ~ NOx__umol_L, data = calib2)
#
# Coefficients:
# (Intercept)  NOx__umol_L
# 4272 5677# Warning in object$coef: partial match of 'coef' to 'coefficients'# Warning in seq.default(from = xlim[[1]], to = xlim[[2]], length = 250): partial
# argument match of 'length' to 'length.out'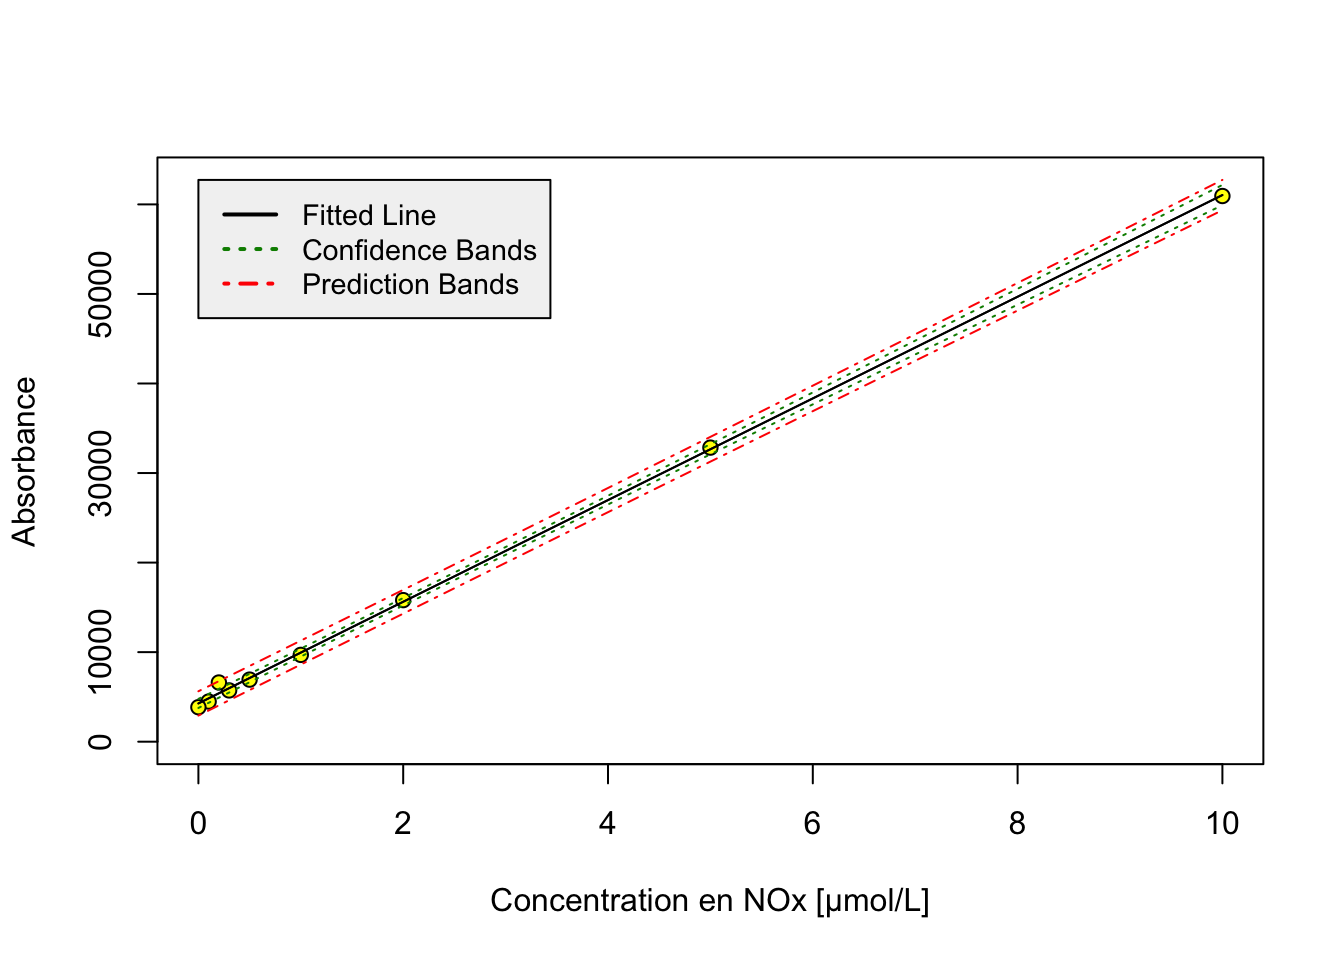
Notez que les enveloppes de confiance et de prédiction sont un tout petit peu plus large. En effet, nous n’avons pas de réplicas pour les solutions standards (elle ne sont passées qu’une seule fois). Cependant, le résultat reste très précis et les points s’alignent très bien linéairement, à part un en troisième position, très légèrement décalé vers le haut. La pente et l’ordonnée à l’origine sont relativement proches de ceux obtenus avec notre premier jeu de données. La réponse de l’appareil est assez stable d’un lot à l’autre.
Nous pouvons maintenant utiliser cette droite pour calculer la concentration des échantillons inconnus à partir de leur absorbance, ainsi que le vecteur des absorbances mesurées pour un seul échantillon. Mais ici, nous n’avons qu’une seule valeur mesurée pour différents échantillons. Nous pouvons appliquer la fonction sur le premeir échantillon comme ceci :
# $Prediction
# [1] 0.081453
#
# $`Standard Error`
# [1] 0.1009759
#
# $Confidence
# [1] 0.2387701
#
# $`Confidence Limits`
# [1] -0.1573171  0.3202231
La concentration prédite pour ce premier échantillon est de 0,081 µmol/L. L’’ereur standard sur cette prédiction est de 0,100 µmol/L, et l’intervalle de confiance vers le haut et vers le bas est de 0,239 µmol/L, ce qui donne un intervalle de prédiction allant de -0,157 à 0,320 µmol/L. Naturellement, des concentrations négatives n’ont aucun sens. Cela veut seulement dire que, comme zéro est compris dans l’intervalle de confiance à 95%, nous ne pouvons pas certifier que des nitrates sont effectivement présentes dans cet échantillon. Et si ils le sont, leur concentration est très, très faible.
Le package {chemCal} fournit également une fonction lod() qui calcule la limite de détection (LOD) et loq(), la limite de quantification (LOQ) pour notre dosage. La LOD est la plus petite concentration que nous pouvons détecter avec certitude, tandis que la LOQ est la plus petite concentration que nous pouvons quantifier avec précision. Ces deux valeurs sont calculées à partir de l’erreur standard de la droite de calibration et du niveau de confiance choisi (par défaut 95%). Voici comment les calculer :
# $NOx__umol_L
# [1] 0.3818868
#
# $abs.NOx
# [1] 6439.595# $NOx__umol_L
# [1] 0.7088053
#
# $abs.NOx
# [1] 8295.547Ainsi avec notre seconde droite de calibration, et si nous n’utilisons qu’une seule mesure par échantillons, nous pourrons détecter des concentrations siginificatives en nitrates + nitrites à partir de 0,38 µmol/L. La quantification ne devient effective qu’à partir de concentrations supérieures ou égales à 0,71 µmol/L. Pour pouvoir détecter ou quantifier des concentrations plus faibles, il faut augmenter le nombres de solutions standards pour obtenir une droite de calibration plus précise et/ou augmenter le nombre de réplicas pour les échantillons inconnus… jusqu’à une certaine limite inhérante à la méthode de dosage. S’il faut être encore plus précis, alors il faut rechercher un autre technique de dosage. Voiyez les pages d’aides ?chemCal::lod et ?chemCal::loq pour plus de détails et pour déterminer comment calculer ces valeurs lorsque les échatillons inconnus sont répliqués.
Revenons à nos échantillons inconnus. Nous pouvons calculer leurs concentrations en une seule fois et inclure les résultats dans le tableau samples comme ceci :
concs <- purrr::map(samples$abs.NOx, chemCal::inverse.predict, object = calib2_lm) |>
  sapply(unlist) |>
  t()
concs
# Prediction Standard Error Confidence Confidence Limits1
# [1,] 0.08145300 0.10097593 0.2387701 -0.1573171
# [2,] 0.47760543 0.10026469 0.2370883 0.2405171
# [3,] 0.04481463 0.10104915 0.2389433 -0.1941286
# [4,] -0.07531697 0.10129796 0.2395316 -0.3148486
# [5,] -0.17290187 0.10150989 0.2400328 -0.4129346
# [6,] -0.11812045 0.10138984 0.2397489 -0.3578693
# [7,] 0.62239747 0.10004186 0.2365614 0.3858361
# [8,] 0.68087795 0.09995755 0.2363620 0.4445159
# [9,] 0.60848193 0.10006241 0.2366100 0.3718719
# Confidence Limits2
# [1,] 0.32022314
# [2,] 0.71469376
# [3,] 0.28375790
# [4,] 0.16421465
# [5,] 0.06713088
# [6,] 0.12162843
# [7,] 0.85895888
# [8,] 0.91724000
# [9,] 0.84509193Ce calcul est un peu compliqué. Il utilise la fonction purrr::map() qui va appliquer de manière récursive la fonction chemCal::inverse.predict() à chaque valeur de samples$abs.NOx. Le résultat est une liste de listes, soit un objet pas très maniable. Nous appelons ensuite la fonction sapply() qui applique à chaque élément de la liste de premier niveau unlist() qui transforme les listes imbriquées en vecteurs. Ensuite, le tout est simplifié en une matrice, mais les lignes et les colonnes sont inversées. Donc, t() transpose ce tableau pour que chaque ligne corresponde à un échantillon. Nous pouvons rajouter cela au tableau samples dont on ne garde que les colonnes pertinentes comme ceci :
#            sample_id abs.NOx  Prediction Standard Error Confidence
# 12 20171122 09:01 1F    4734  0.08145300     0.10097593  0.2387701
# 13 20171122 09:01 2F    6983  0.47760543     0.10026469  0.2370883
# 14 20171122 09:01 3F    4526  0.04481463     0.10104915  0.2389433
# 15 20171122 09:01 4F    3844 -0.07531697     0.10129796  0.2395316
# 16 20171122 09:01 5F    3290 -0.17290187     0.10150989  0.2400328
# 17 20171122 09:01 6F    3601 -0.11812045     0.10138984  0.2397489
# 18 20171122 09:59 1O    7805  0.62239747     0.10004186  0.2365614
# 19 20171122 09:59 2O    8137  0.68087795     0.09995755  0.2363620
# 20 20171122 09:59 3O    7726  0.60848193     0.10006241  0.2366100
#    Confidence Limits1 Confidence Limits2
# 12         -0.1573171         0.32022314
# 13          0.2405171         0.71469376
# 14         -0.1941286         0.28375790
# 15         -0.3148486         0.16421465
# 16         -0.4129346         0.06713088
# 17         -0.3578693         0.12162843
# 18          0.3858361         0.85895888
# 19          0.4445159         0.91724000
# 20          0.3718719         0.84509193
Nous voyons que certaines prédictions de concentrations sont négatives. Ce n’est pas gênant. Cela se produit lorsque la concentration est très très faible et très inférieure à la limite de détection. Dès lors, l’erreur de mesure sur l’absorbance, et l’incertitude sur la droite de calibration puet avoir pour conséquence que certaines valeurs prédites sont légèrement négatives. Naturellement, dans le rapport final, nous reprterons ces valeurs comme “<xxx”, ou “xxx” est la limite de détection.
1.3.5 Calculs directement dans Excel
Pour des droites de calibration et des calculs de concentrations inconnues simples, sans statistiques supplémentaires telles que les intervalles de confiance, le LOD et le LOQ, il est possible de travailler directement dans un fichier Excel. Cela peut rendre des services, même si c’est moins complet, et nettement moins pratique pour des grands séries d’analyse qu’avec R, où les scripts sont automatisables facilement.
Nous ne présentons pas dans le cours comment faire, mais vous le réaliserez vous-même dans le projet individuel.
À vous de jouer !
Réalisez le tutoriel ci-dessous pour affinier votre compréhension de la droite de calibration et son utilisation pour calculer des concentrations inconnues.
Effectuez maintenant les exercices du tutoriel B01La_calib (Tutoriel droite de calibration).
BioDataScience2::run("B01La_calib")